在英文作文中(尤其是考试作文),段首通常需要缩进(段首空两格或大约 5 个字母的宽度),就像中文写作段落首行空两个字一样。这是标准的排版规范。 ✅ 所以: 纸笔考试(如六级):段首请空两格或用一个小的空格来模拟缩进。 在电脑上打字时(如Word文档或电子投稿):推荐使用Tab键缩进(默认约 5 个字母宽度),也可以通过段落格式设置“首行缩进”。 ❌ 不建议的格式: 段落首行顶格写(没有缩进) 段落之间不留空行也不缩进(容易显得格式混乱) 案例 ✅ Part 1:六级作文**“完美通用模板”**(三段式) ✨【第一段】引出话题 + 明确态度 “题干句”This trend reflects th…
Translation (30 minutes) Directions: For this part, you are allowed 30 minutes to translate a passage from Chinese into English. You should write your answer on Answer Sheet 2. 中国盛产竹子,是最早开发利用竹资源的国家。竹子在中国分布广泛,品种丰富。竹子实用性强,用 于生产和生活的许多方面,如筷子、桌椅的制作和桥梁、房屋的建造。中国人爱竹,自古以来就有无数文 人以竹为主题,创作了绚丽多彩的文学和绘画作品。竹子主干(ste…
听力 I have indeed and I wish to sign the agreement, pending one small change to be made a contract.
empirical paradigm synthesis plausible ubiquitous mitigate cohesive infrastructure egalitarian stereotype feasible meritocracy scrutiny prerequisite intrinsic convergence ephemeral dichotomy utopia dogma sublime procrastinate resilience altruist…
计算机视觉 cv 基于ppt

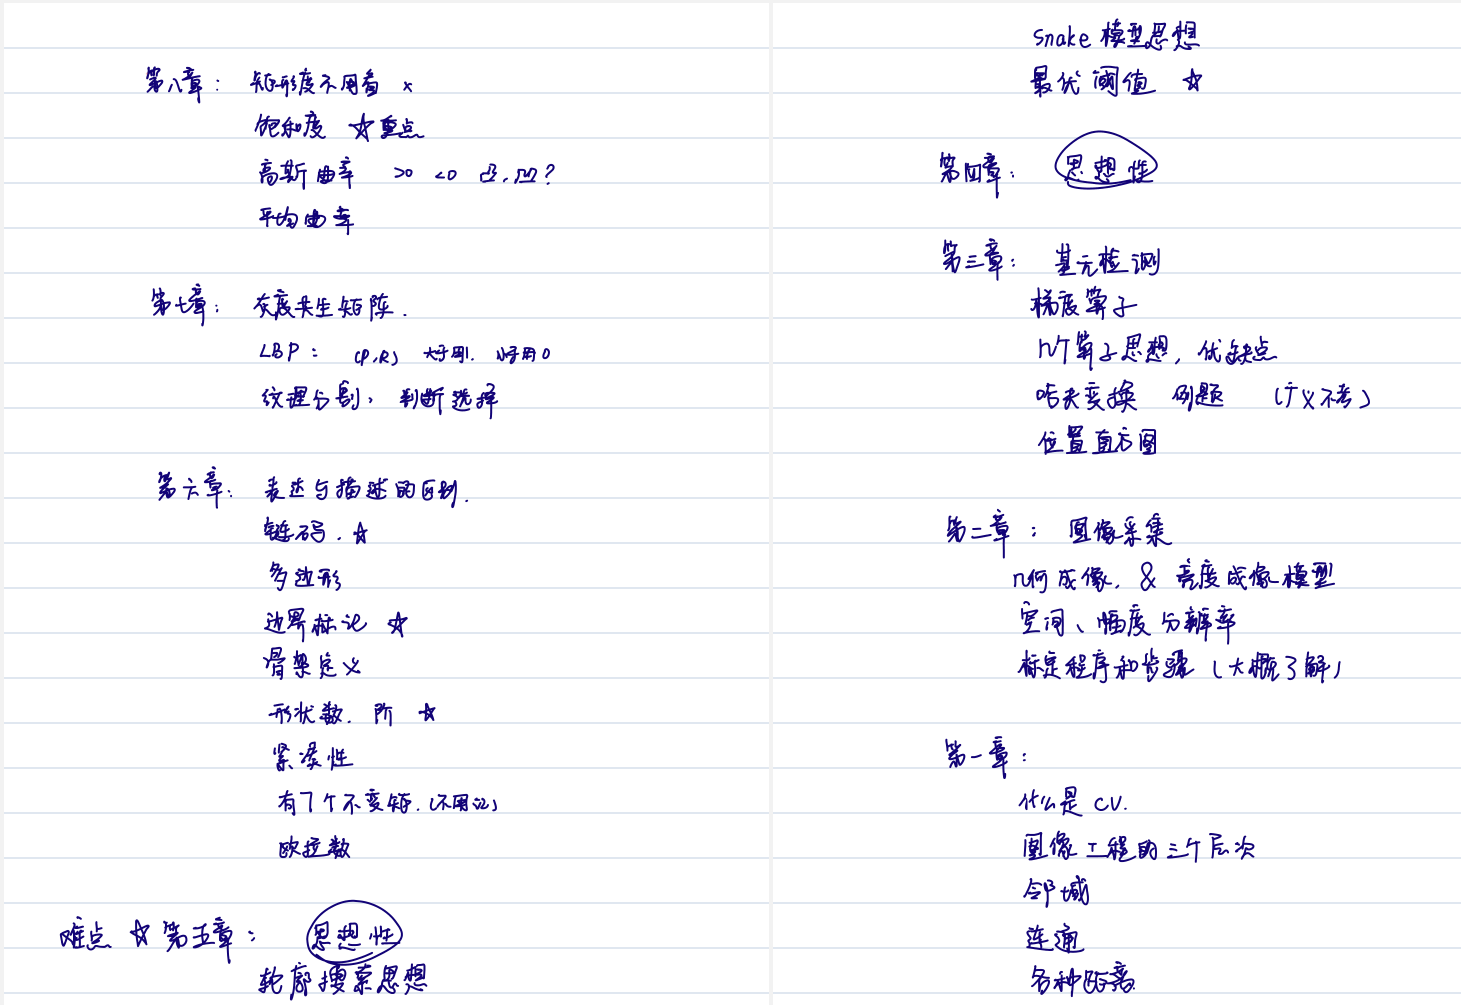
基元检测是指在图像中识别和定位基本的几何元素(称为“基元”),如边缘、角点、线段、圆、矩形等简单的几何形状或特征。 目标分割是将图像划分为多个有意义的区域或对象,每个区域通常对应一个完整的目标或语义部分。 1 绪论 1.2 图像基础 1.3 像素间联系 1.3.1 像素邻域 1.3.2 像素间距离 欧氏距离 城区距离 棋盘距离 一般用棋盘距离进行距离变换 2 图像采集 2.1 采集装置 2.2 采集模型 2.2.1 几何成像模型 2.2.2 亮度成像模型 2.3 采集方式 2.3.1 成像方式一览 2.3.2 结构光法 2.4 摄像机标定 2.4.1 标定程序和步骤 2.4.2 两级标定法 3…
NLP 框架 CQU
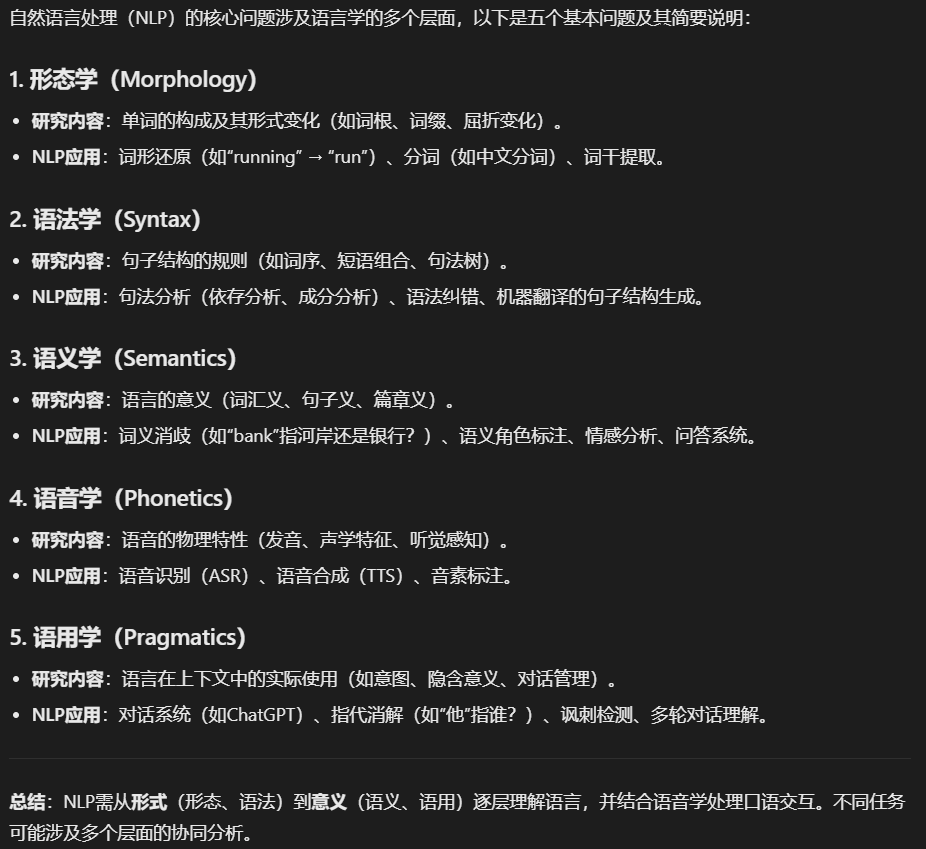
统计语言模型,神经网络模型, 预训练模型 1 绪论(了解) 自然语言处理(NLP)的定义是什么? 自然语言处理(Natural Language Processing,NLP)是人工智能领域的一个重要分支,专注于通过计算机技术实现人类自然语言的理解、解析、生成和交互。其核心目标是使计算机能够像人类一样处理语言数据,从而支持机器翻译、情感分析、文本摘要、问答系统等实际应用。 NLP发展的四个阶段: 初创期 理性主义时代 经验主义时代 深度学习时代 1. 初创期(1950s-1970s) 特点:基于规则和符号逻辑,依赖语言学理论。 技术:手工编写语法规则(如上下文无…
NLP ppt
统计语言模型, 神经网络 模型和预训练模型 1 绪论 1. 基本概念 (p.1) 1.1 术语定义 ▪️ 计算语言学(CL)、自然语言处理(NLP)、自然语言理解(NLU)常被视为同义概念▪️ 刘颖(2002)专著中将三者直接等同【需确认】是否所有文献都接受这种等同关系 1.2 HLT发展历史 ▪️ 1946年ENIAC计算机诞生标志着技术起点▪️ 关键人物:Warren Weaver(信息论先驱)、A.D.Booth(计算机科学家)▪️ Norbert Wiener首次提出机器翻译设想 2. 发展历程 (p.3) 2.1 初创期(1950s-1960s) 2.1.1 学术里程碑 ▪️ 195…
大数据计算 ppt
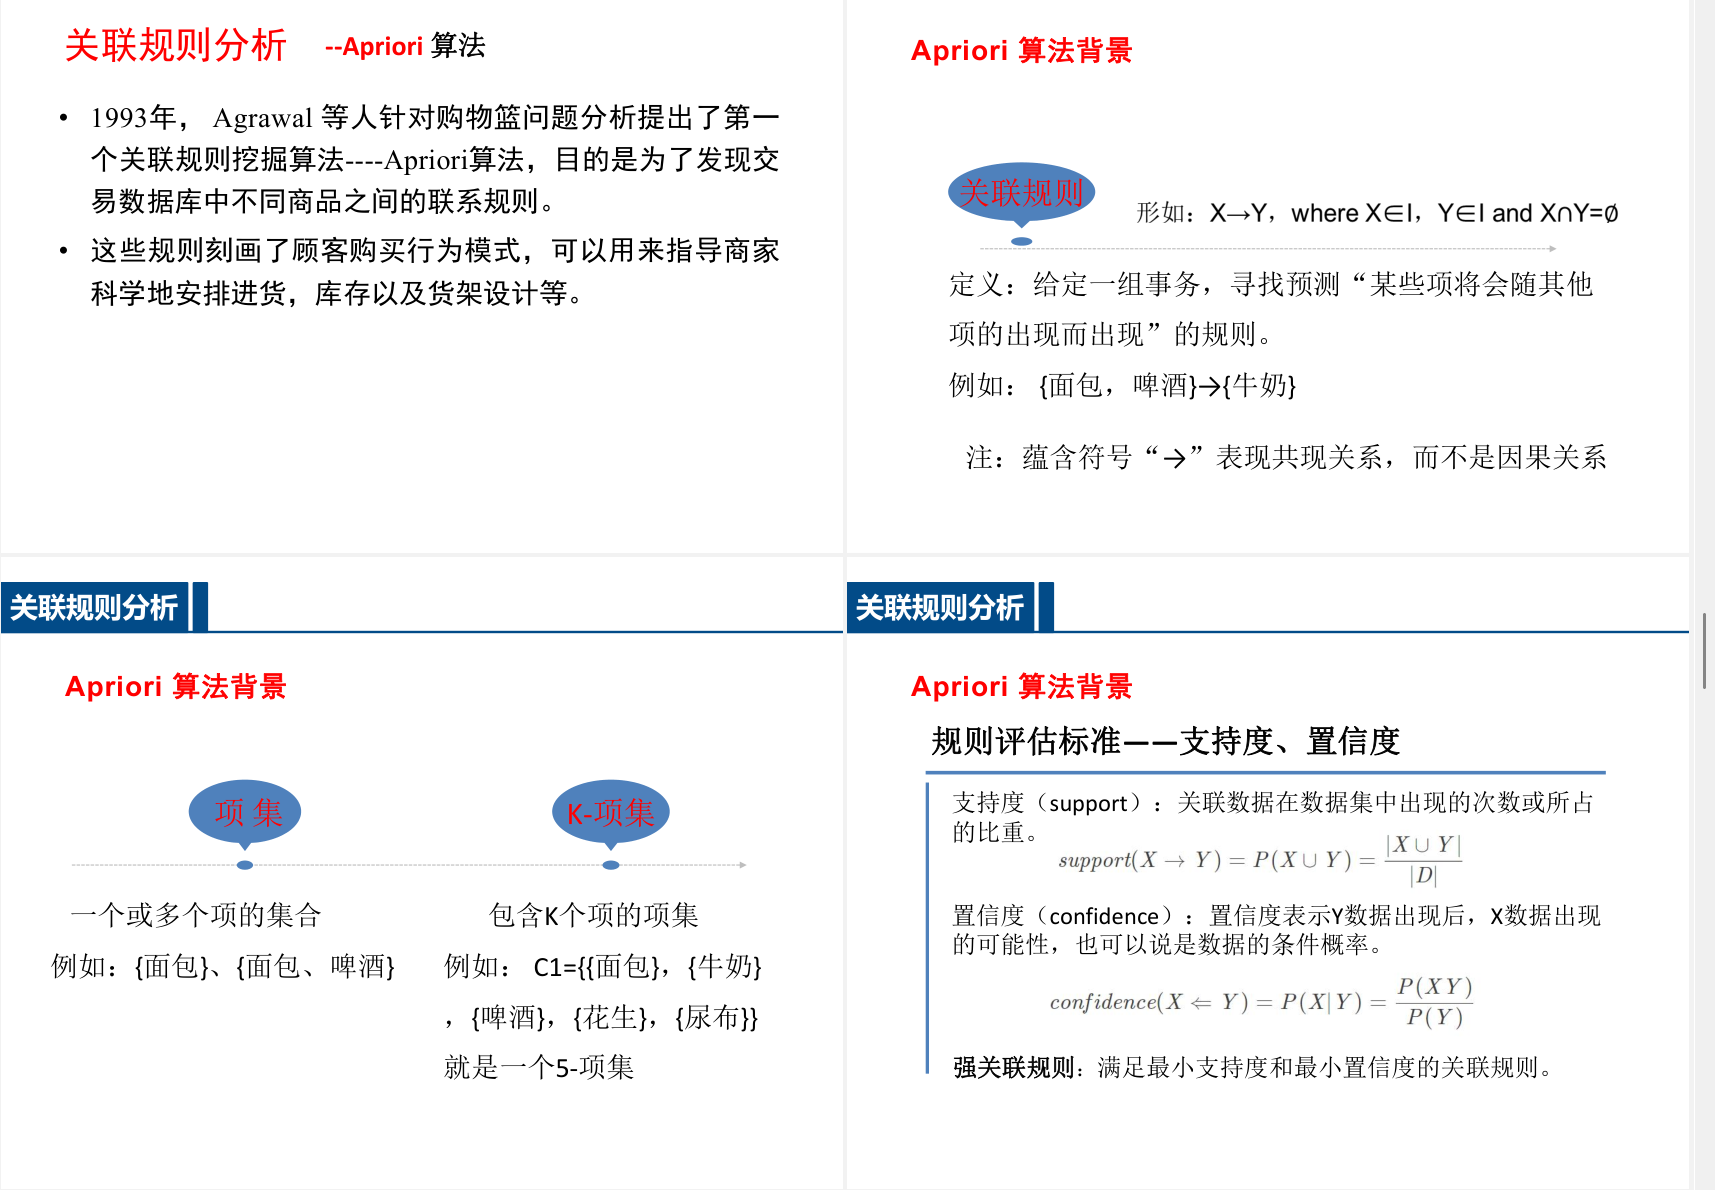
1 绪论 1.1 什么是大数据 定义与背景 维基百科:无法用常规软件工具处理的数据集合 《大数据时代》:采用所有数据(非抽样)进行分析 Gartner:需新处理模式的海量、高增长率、多样化信息资产 背景: 数据量迅猛增长(如2001年全年流量在2013年仅需一天) 数据可挖掘的高价值(社会需求驱动精细化管理) 特点(4V) Volume:规模大,资源消耗高 Velocity:产生速度快,实时性要求高 Variety:来源与形式多样 Value:价值密度低但总量大 1.2 哪里有大数据 来源: 互联网(社交网络、日志、富媒体) 事业单位/政府(医疗影像、电网信息) 大型设备(波音787飞行数据、…
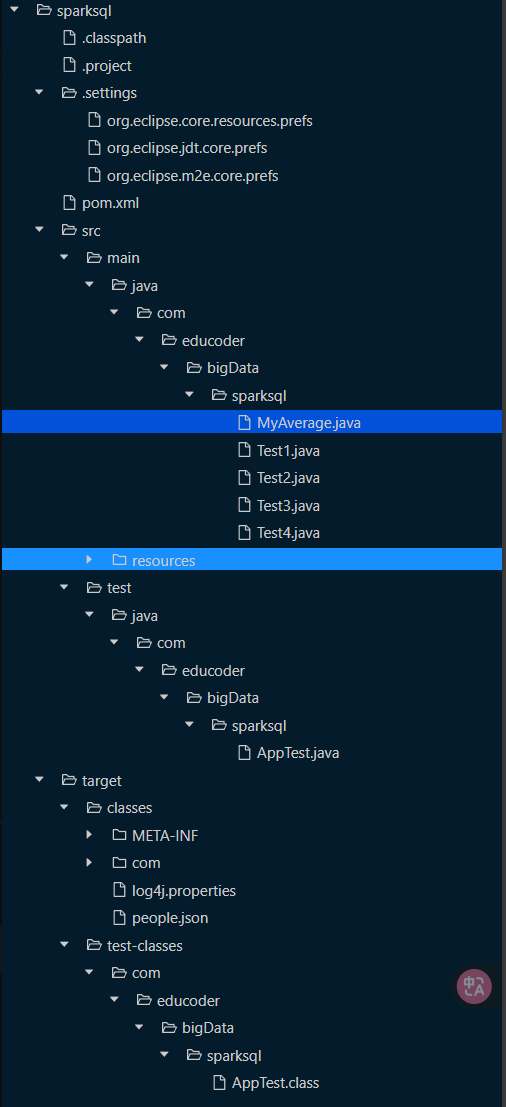
CQU大数据计算 第四次实验 SparkSQL结构化数据分析与处理/Spark 结构化流处理
1 SparkSQL结构化数据分析与处理 1.1 SparkSQL简单使用 1.1.1 第1关:SparkSQL初识 sparksql/src/main/java/com/educoder/bigData/sparksql/Test1.java package com.educoder.bigData.sparksql; import org.apache.spark.sql.AnalysisException; import org.apache.spark.sql.Dataset; import org.apache.spark.sql.Row; import org.apache.spa…
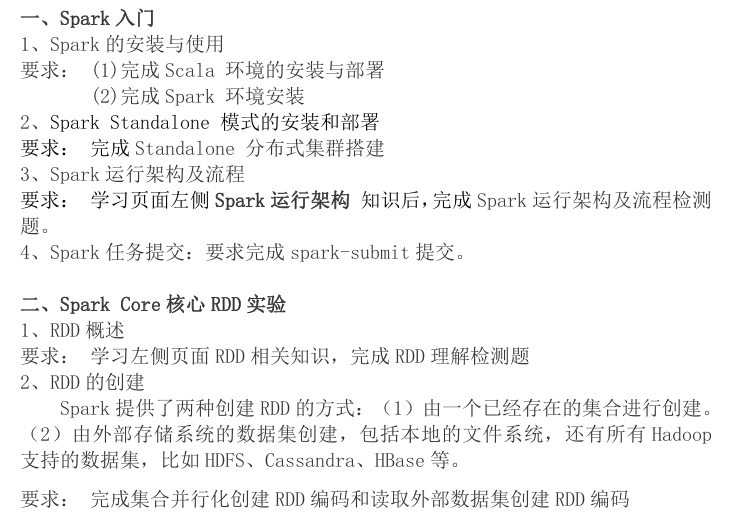
大数据计算 实验3 Spark Core 核心 RDD
概述:本次实验中,在搭建Spark Standalone模式分布式集群时花了大量时间,除此之外,按照教程没遇到任何问题,都能成功简单复现. Standalone 分布式集群搭建遇到的麻烦 ulimit -f 1024000 cd /home 注意到wrapdocker会出现iptable相关错误,并且尝试更新,修复模块失败(推测是禁止了外网网络连接)所以采用禁止iptable方式启动docker sudo dockerd --iptables=false > /var/log/docker.log 2>&1 & 加载镜像 docker load -i hbase-ssh2_v1…