量化金融领域因子挖掘(alpha factor discovery/因子生成)的发展历程,可分为四个划时代阶段:传统人工符号因子(1990s-2015)、机器学习自动化挖掘(2016-2020)、深度学习非线性隐因子(2020-2023)、以及LLM交互式/代理式智能生成(2023至今)。 这一演进核心是从“人工经验+统计检验”转向“数据驱动自动化”,再到“可解释+人机协作”,解决了“因子动物园”(factor zoo)爆炸、p-hacking、多重检验偏差、不可解释性等问题。传统方法依赖人工设计(如Fama-French价值/规模),ML/DL实现高维搜索与非线性提取,LLM则引入自然语言推…
WordPress 网站迁移完整复盘 📋 迁移流程总结 阶段一:源服务器准备 备份网站文件 tar -czf blog.mozhongzhou.cn.tar.gz /var/www/wordpress 备份数据库 mysqldump -u username -p database_name > blog_mozhongzhou_full.sql 阶段二:新服务器环境搭建 安装必要软件 # 更新系统 sudo apt update && sudo apt upgrade -y # 安装 Nginx、PHP、MySQL sudo apt install nginx php8.…

数据库原理 设计 / 计算机三级 计算机四级 数据库

关系模型(关系数据模型)的“键(Keys)与完整性约束(Integrity Constraints)” 主键/外键:对应实体完整性、参照完整性,偏“约束/实现/建表规则”。 候选键/超键/备用键:偏“如何唯一标识元组(行)”,是理论基础。 函数依赖(Functional Dependency, FD)与规范化(范式 / Normalization) 候选键、主属性等,是做范式判断时的“工具变量”。 超键 候选键 主键 外键 一张“包含关系”速记 候选键 ⊂ 超键 主键 = 选定的候选键 外键 = 引用别表键的属性(可重复,可为空取决于约束) E-R 图常见符号含义(以 Chen 记法为主) 方…
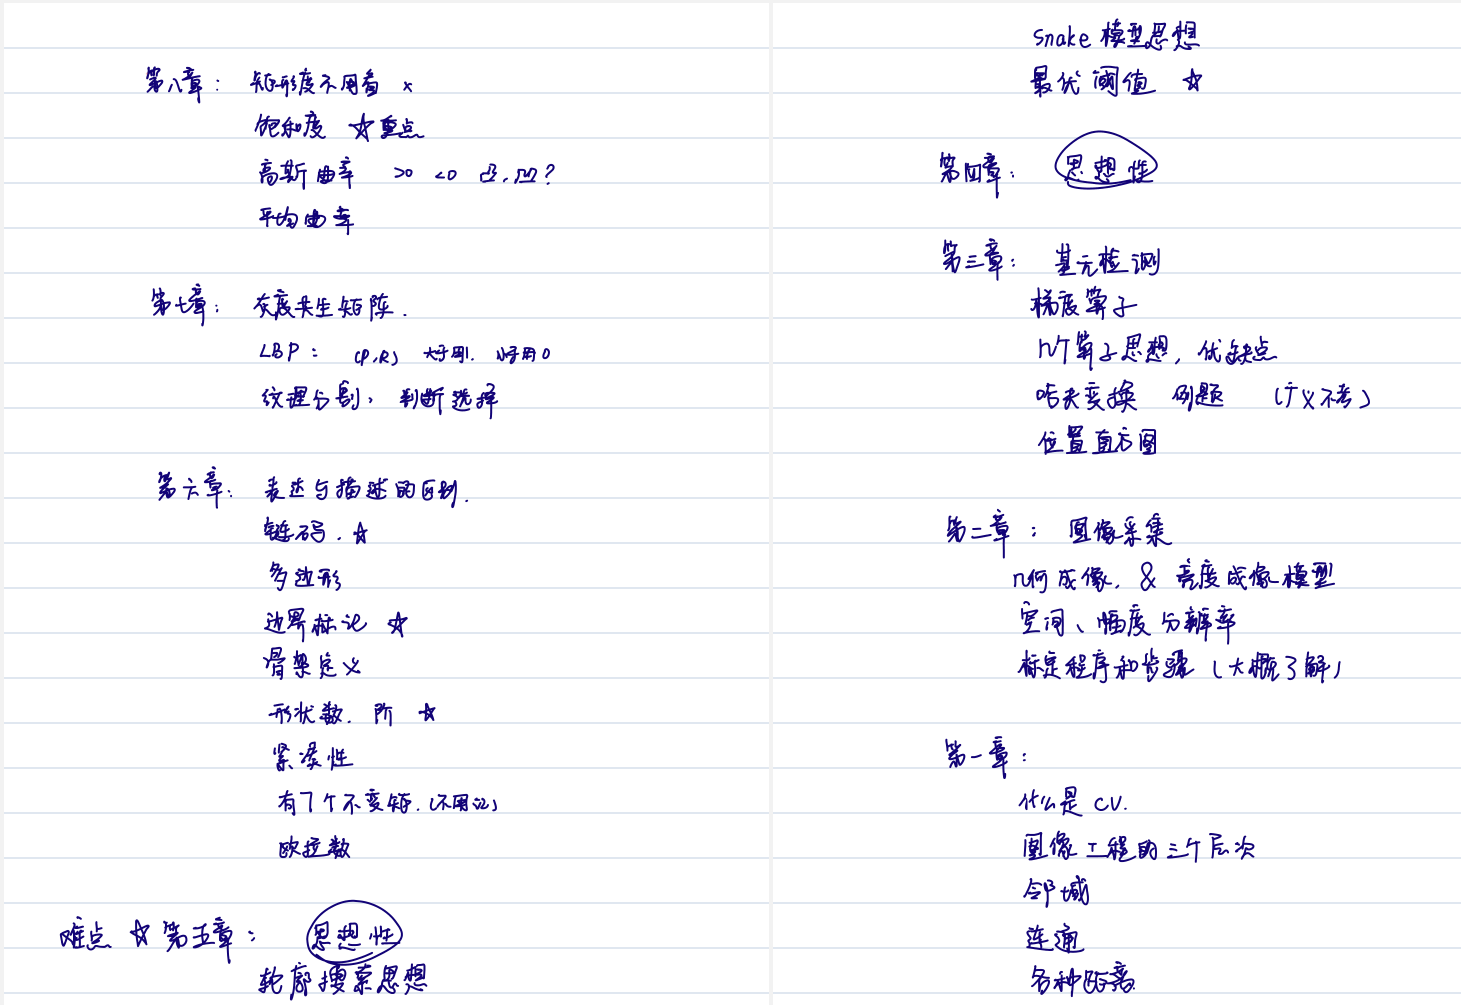
计算机视觉 cv 基于ppt
基元检测是指在图像中识别和定位基本的几何元素(称为“基元”),如边缘、角点、线段、圆、矩形等简单的几何形状或特征。 目标分割是将图像划分为多个有意义的区域或对象,每个区域通常对应一个完整的目标或语义部分。 1 绪论 1.2 图像基础 1.3 像素间联系 1.3.1 像素邻域 1.3.2 像素间距离 欧氏距离 城区距离 棋盘距离 一般用棋盘距离进行距离变换 2 图像采集 2.1 采集装置 2.2 采集模型 2.2.1 几何成像模型 2.2.2 亮度成像模型 2.3 采集方式 2.3.1 成像方式一览 2.3.2 结构光法 2.4 摄像机标定 2.4.1 标定程序和步骤 2.4.2 两级标定法 3…
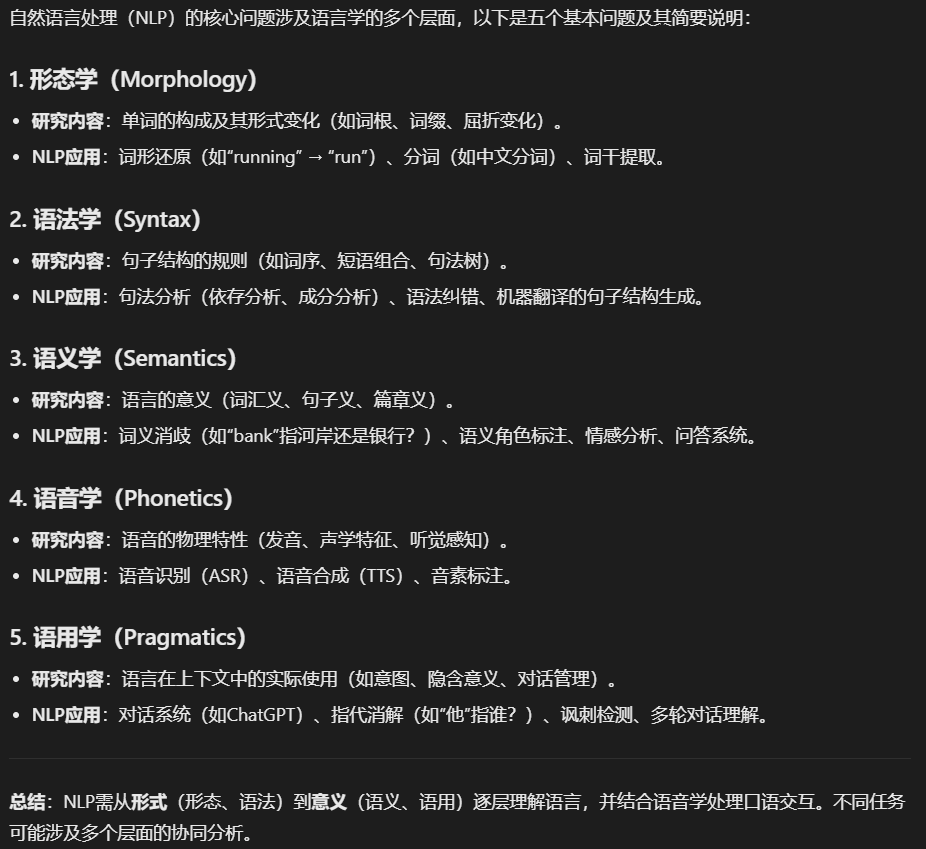
NLP 框架 CQU
统计语言模型,神经网络模型, 预训练模型 1 绪论(了解) 自然语言处理(NLP)的定义是什么? 自然语言处理(Natural Language Processing,NLP)是人工智能领域的一个重要分支,专注于通过计算机技术实现人类自然语言的理解、解析、生成和交互。其核心目标是使计算机能够像人类一样处理语言数据,从而支持机器翻译、情感分析、文本摘要、问答系统等实际应用。 NLP发展的四个阶段: 初创期 理性主义时代 经验主义时代 深度学习时代 1. 初创期(1950s-1970s) 特点:基于规则和符号逻辑,依赖语言学理论。 技术:手工编写语法规则(如上下文无…
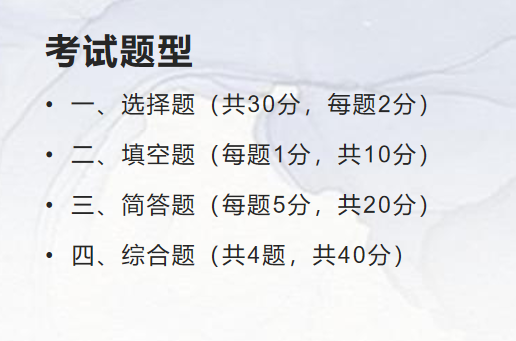
NLP ppt
统计语言模型, 神经网络 模型和预训练模型 1 绪论 1. 基本概念 (p.1) 1.1 术语定义 ▪️ 计算语言学(CL)、自然语言处理(NLP)、自然语言理解(NLU)常被视为同义概念▪️ 刘颖(2002)专著中将三者直接等同【需确认】是否所有文献都接受这种等同关系 1.2 HLT发展历史 ▪️ 1946年ENIAC计算机诞生标志着技术起点▪️ 关键人物:Warren Weaver(信息论先驱)、A.D.Booth(计算机科学家)▪️ Norbert Wiener首次提出机器翻译设想 2. 发展历程 (p.3) 2.1 初创期(1950s-1960s) 2.1.1 学术里程碑 ▪️ 195…
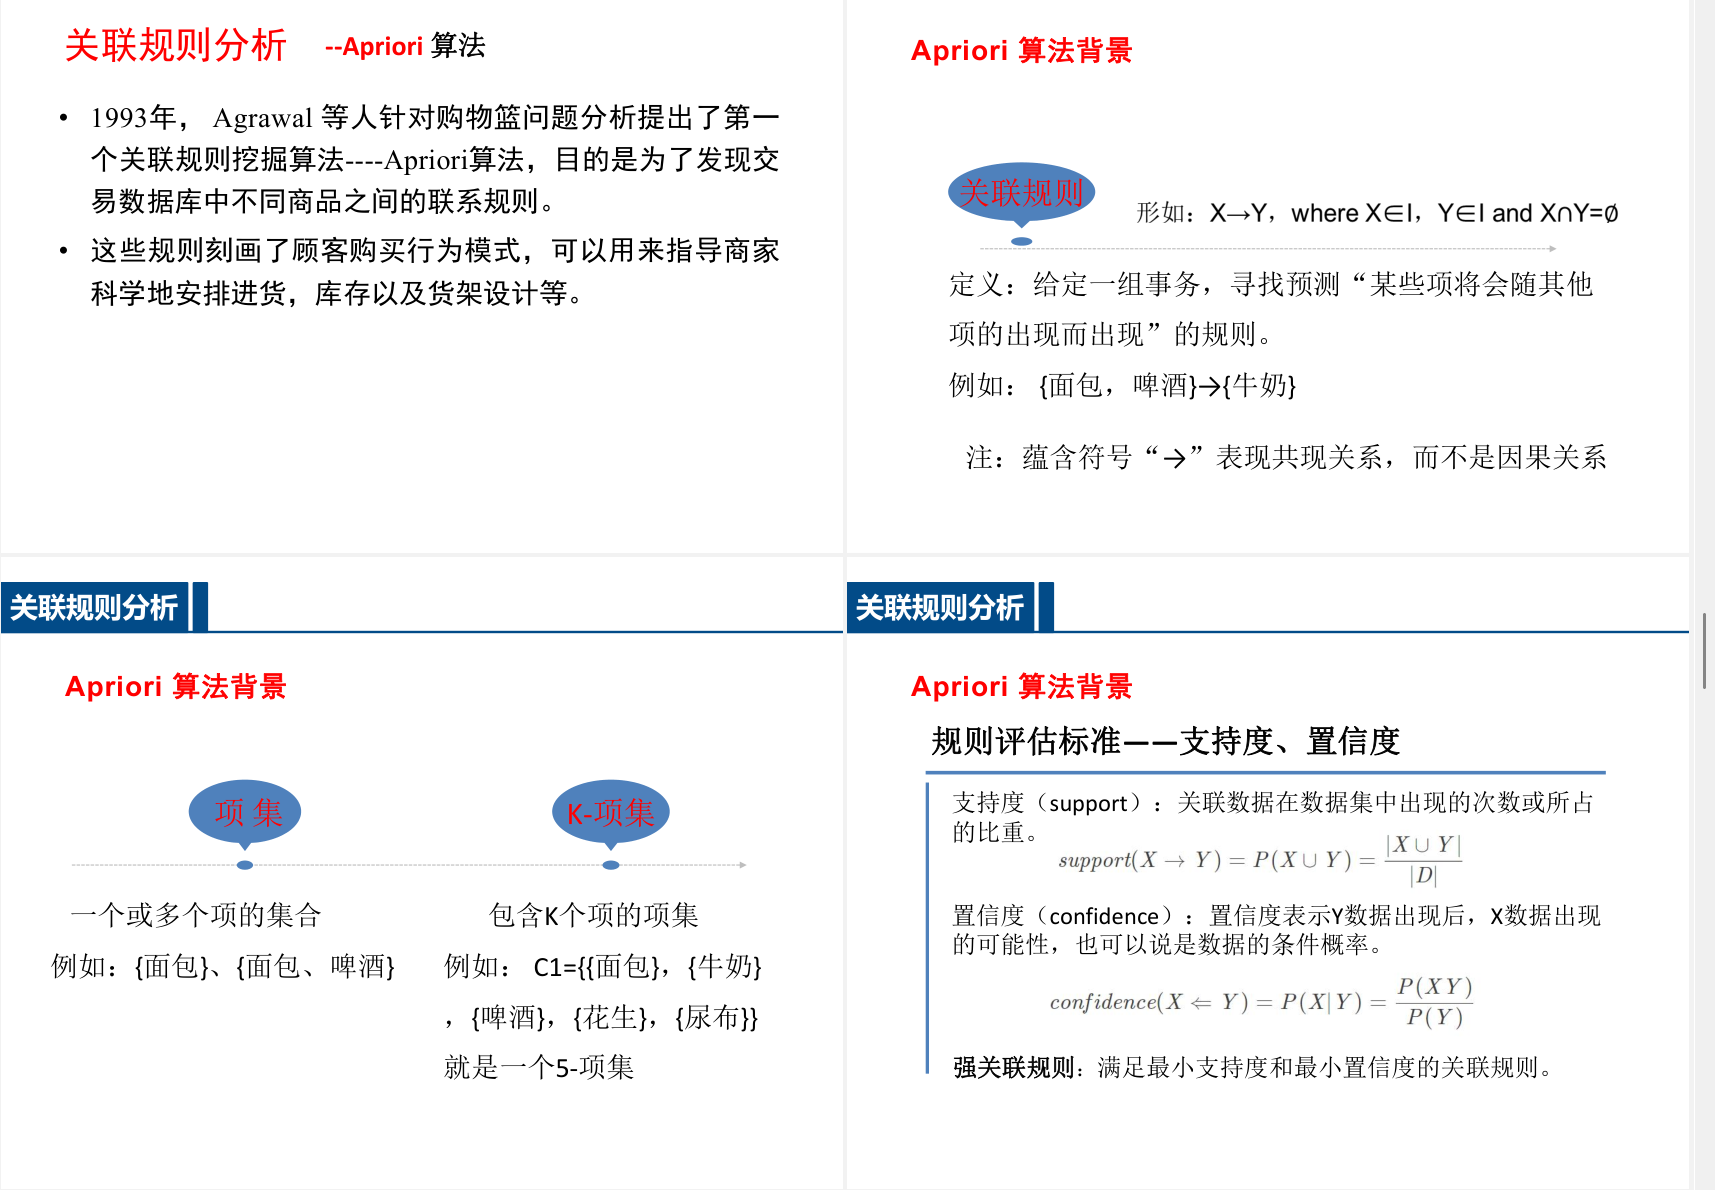
大数据计算 ppt
1 绪论 1.1 什么是大数据 定义与背景 维基百科:无法用常规软件工具处理的数据集合 《大数据时代》:采用所有数据(非抽样)进行分析 Gartner:需新处理模式的海量、高增长率、多样化信息资产 背景: 数据量迅猛增长(如2001年全年流量在2013年仅需一天) 数据可挖掘的高价值(社会需求驱动精细化管理) 特点(4V) Volume:规模大,资源消耗高 Velocity:产生速度快,实时性要求高 Variety:来源与形式多样 Value:价值密度低但总量大 1.2 哪里有大数据 来源: 互联网(社交网络、日志、富媒体) 事业单位/政府(医疗影像、电网信息) 大型设备(波音787飞行数据、…
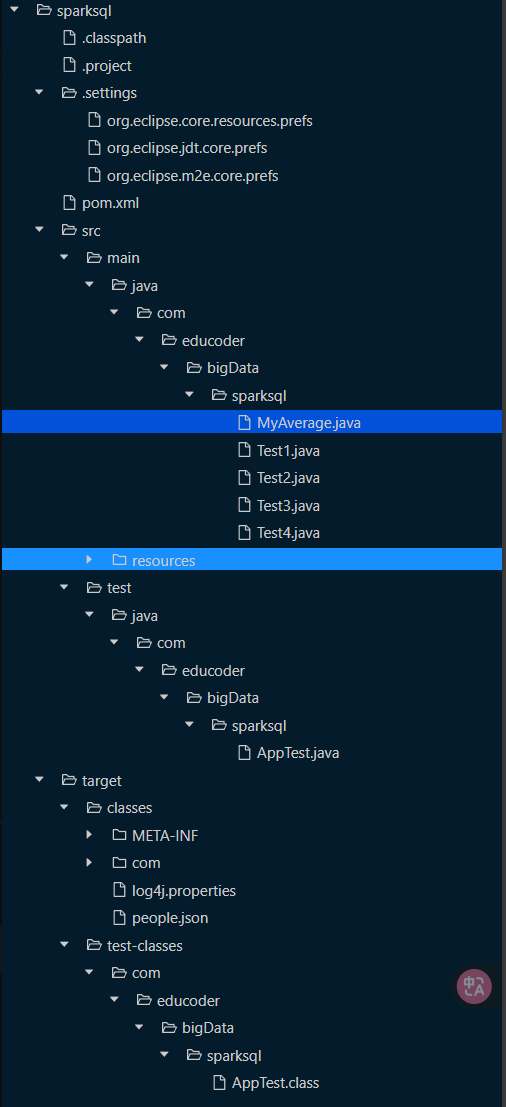
CQU大数据计算 第四次实验 SparkSQL结构化数据分析与处理/Spark 结构化流处理
1 SparkSQL结构化数据分析与处理 1.1 SparkSQL简单使用 1.1.1 第1关:SparkSQL初识 sparksql/src/main/java/com/educoder/bigData/sparksql/Test1.java package com.educoder.bigData.sparksql; import org.apache.spark.sql.AnalysisException; import org.apache.spark.sql.Dataset; import org.apache.spark.sql.Row; import org.apache.spa…
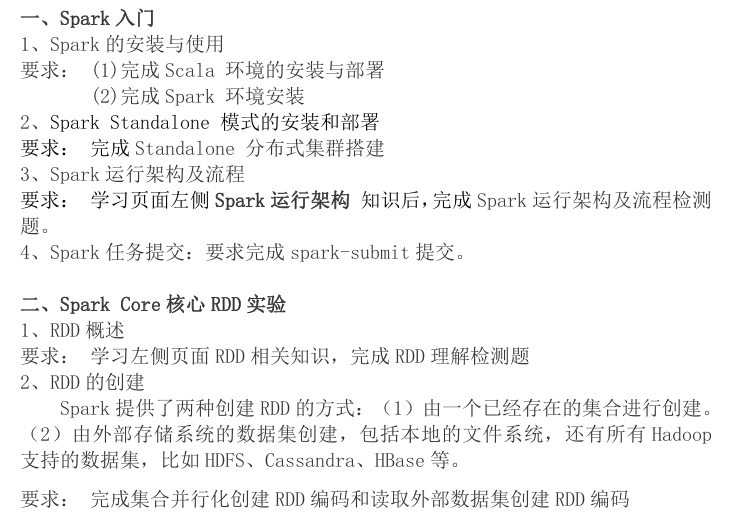
大数据计算 实验3 Spark Core 核心 RDD
概述:本次实验中,在搭建Spark Standalone模式分布式集群时花了大量时间,除此之外,按照教程没遇到任何问题,都能成功简单复现. Standalone 分布式集群搭建遇到的麻烦 ulimit -f 1024000 cd /home 注意到wrapdocker会出现iptable相关错误,并且尝试更新,修复模块失败(推测是禁止了外网网络连接)所以采用禁止iptable方式启动docker sudo dockerd --iptables=false > /var/log/docker.log 2>&1 & 加载镜像 docker load -i hbase-ssh2_v1…
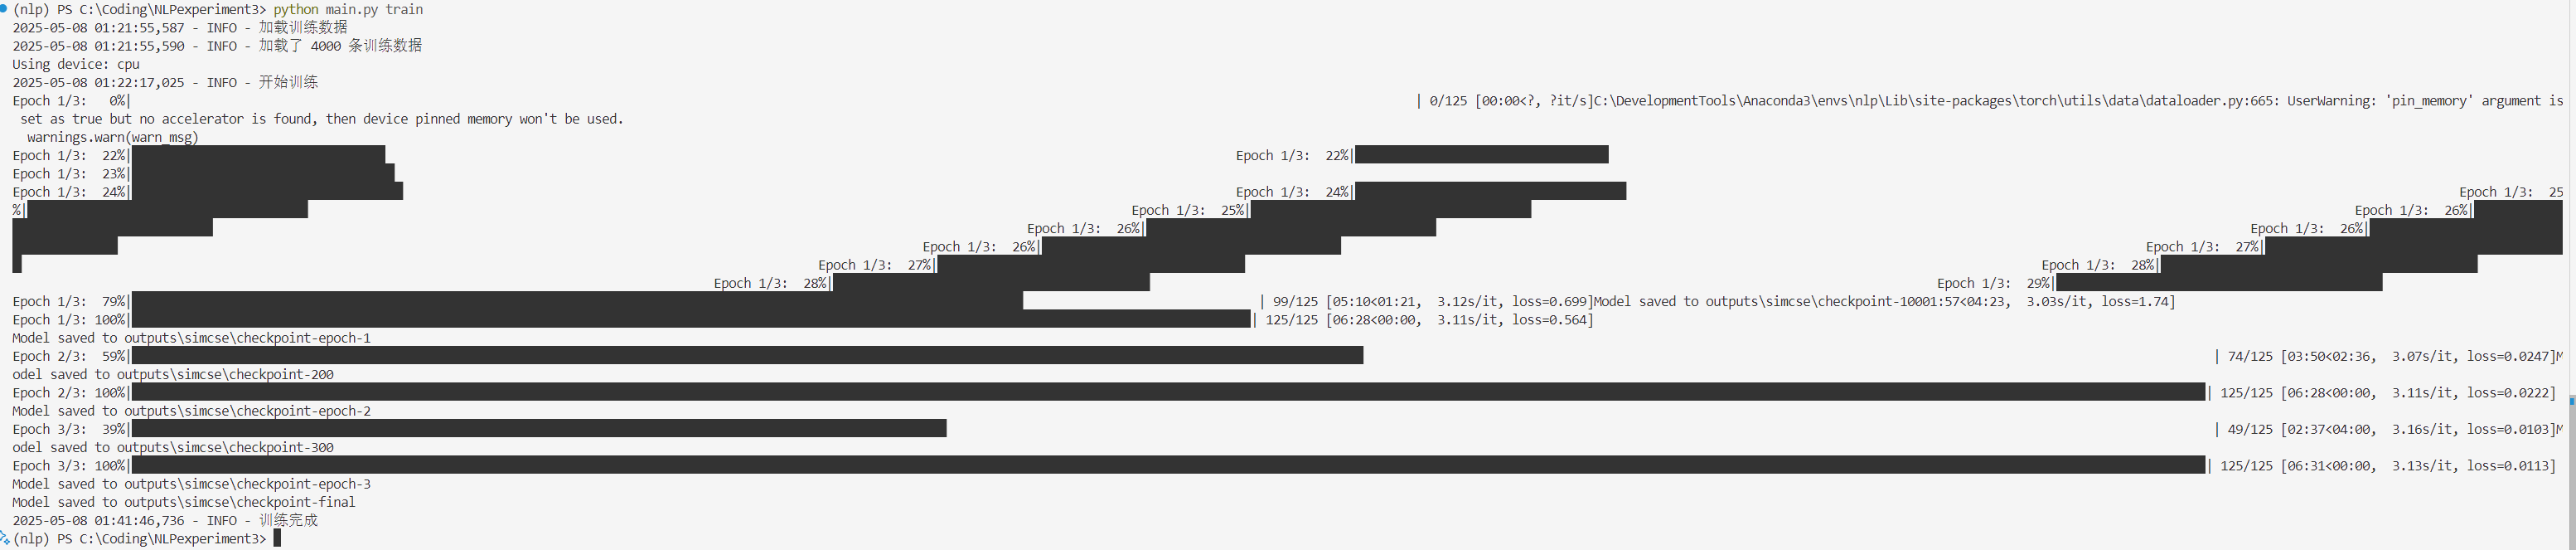
NLP 实验3 FAQ 政务问答
训练模型 构建索引 测试性能 检测服务api情况 实际效果受制于训练数据集和训练参数,模型效果针对不同问题参差不齐 政务问答 FAQ 系统 基于 SimCSE 和 WR 策略的无监督政务问答检索系统,能够高效处理政府工作人员日常政策解读工作。 项目特色 低门槛 无需相似 Query-Query 标注数据 使用无监督对比学习构建语义检索系统 效果好 采用预训练语言模型 BERT 作为基础编码器 集成 WR(Word Repetition)策略增强语义表示 性能快 基于 FAISS 高效向量检索 轻量级 API 服务快速部署 环境要求 Python 3.8+ PyTorch 2.0+ FAISS …